这页解决什么问题:2026 年的 Agent 框架多到选不过来。本地优先的、云端的、写代码的、拖拽式的、单 Agent 的、多 Agent 的——每个都自称"最适合你"。我把 Hermes、OpenClaw 和 18 个主流框架挨个研究了一遍,得出的结论是:选型这件事,先别管框架,先回答三个问题。这页就是给你那三个问题,和一张能直接查的表。
TL;DR
- 没有"最好的框架"。选型看三个维度:本地 vs 云端、单 Agent vs 多 Agent、写代码 vs 低代码。
- 数据敏感、要深度定制的,走本地优先(Hermes、Aider 这类);团队协作、要审计的,走云端编排。
- 记忆层决定一个 Agent 能不能"记住你":5 层架构(工作/短期/长期/程序性/核心)是当前公认的解法。
- 新手最容易犯的错不是选错,是一上来就上多 Agent——协调成本远超想象,单 Agent 先把事跑通再说。
一、选型就问三个问题
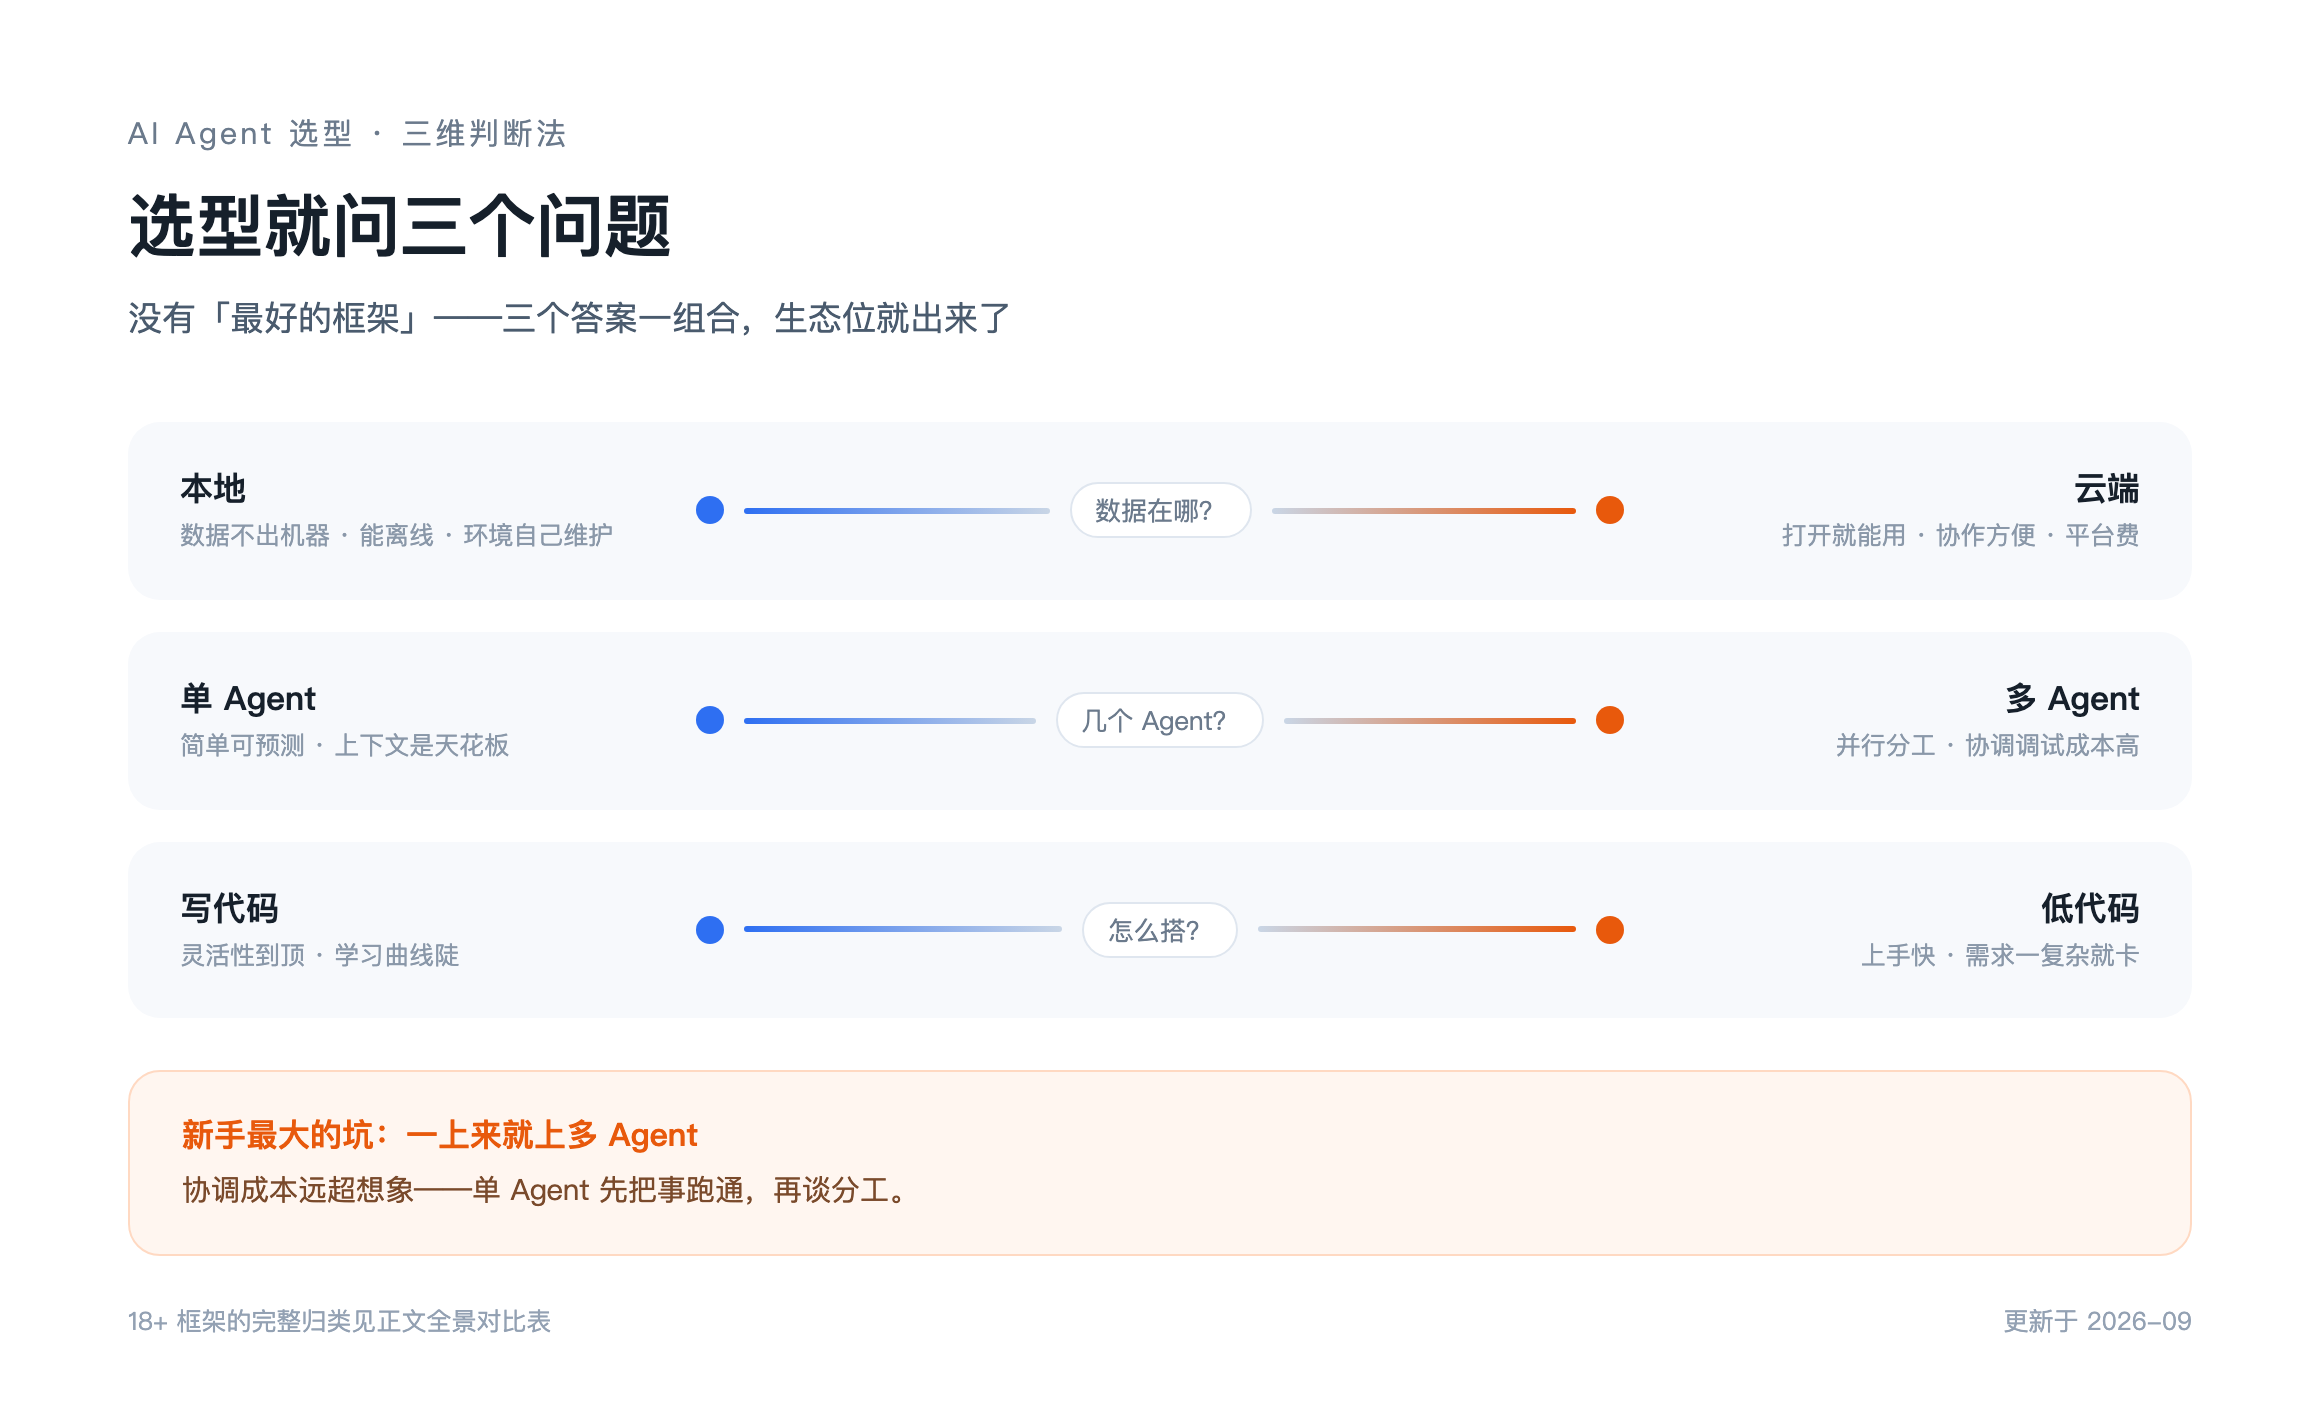
研究完这批框架,有个反直觉的结论:它们之间不是"谁碾压谁",而是各自让渡了一些东西、换来了另一些。判断哪个适合你,三个问题就够了。
1. 本地还是云端?
本地 = 数据不出你的机器,能离线跑,改到代码层都没人管;代价是环境自己维护。云端 = 打开就能用,队友协作方便;代价是数据在平台手里,还要付平台费。
2. 单 Agent 还是多 Agent?
单个 Agent 简单、可预测,但上下文窗口就是天花板。多个 Agent 能并行、能分工,但协调和调试的成本是实打实的——我见过太多人在这上面花的时间比任务本身还长。
3. 写代码还是低代码?
代码级框架灵活性到顶,学习曲线也陡;低代码上手快,但需求一复杂就被平台能力卡脖子。
三个答案一组合,框架的"生态位"就出来了。下面是全部 18+ 框架的归类。
二、全景对比表
本地优先框架
| 框架 | 语言 | 核心特点 | 适用场景 |
|---|---|---|---|
| Hermes | TypeScript | 本地优先 + 多模型 fallback + 插件生态 | 个人自动化、深度研究 |
| Aider | Python | 与 Git 深度集成 | 代码协作 |
| Claude Code | TypeScript | 厂商官方工具 | 对应模型的深度用户 |
| OpenCode | Go | 终端优先、轻量 | 快速编码 |
| OpenHands | Python | 沙盒执行 | 安全敏感任务 |
云端 / 企业框架
| 框架 | 出品方 | 核心特点 | 适用场景 |
|---|---|---|---|
| LangGraph | LangChain | 状态图编排 | 复杂工作流 |
| CrewAI | 独立项目 | 角色扮演式多 Agent | 团队模拟 |
| AutoGen | Microsoft | 对话式多 Agent | 研究、企业场景 |
| Swarm | OpenAI | 轻量多 Agent | 学习、原型验证 |
| OpenClaw | 独立项目 | 可视化编排 + 云端执行 | 团队工作流 |
专项框架
| 框架 | 核心特点 | 适用场景 |
|---|---|---|
| MemGPT / Letta | 5 层记忆架构的源头 | 长期对话、知识管理 |
| Dify | 低代码 Agent 构建 | 快速原型 |
| Coze | 中文生态友好 | 国内部署 |
| Cursor / Windsurf / Trae / Cline / Roo Code | IDE 集成类 | 日常编码 |
三、两个代表摆一起看
Hermes(本地优先的代表) 的设计逻辑值得拆开说:
- 本地优先:文件系统、Git、本地工具链就是它的基础设施。每一步都可审查,断网也能跑。
- 多模型 fallback:不绑死一家模型供应商。主模型挂了自动切备用,用户没感知;每个供应商有独立的超时和重试策略。更进一步,可以按任务类型路由——代码任务走擅长代码的模型,日常对话走高性价比的。
- 插件生态:MCP 协议 + 技能系统 + 自定义工具。工具在独立进程里跑,崩了不影响主 Agent。
云端编排平台 的取舍正好相反:拖拽式工作流、学习曲线平缓、多人共享、企业级权限审计。换来的是不能离线、数据在云端、灵活度封顶。
一句话:本地优先框架把控制权给你,云端平台把便利性给你。你更舍不得哪个,答案就出来了。
四、记忆层:Agent 的"第二大脑"
很多人用了一阵 Agent 才发现:它不记得你。LLM 的上下文窗口是一次性的,对话结束记忆清零。要让它"记得住",得靠外部记忆层。目前公认的做法是 5 层架构(源头是 MemGPT/Letta):
| 层级 | 内容 | 生命周期 | 作用 |
|---|---|---|---|
| 1 工作记忆 | 当前任务上下文 | 单次会话 | 处理眼前的事 |
| 2 短期记忆 | 近期对话摘要 | 会话间传递 | 保持连续 |
| 3 长期记忆 | 向量库存的事实与知识 | 持久化 | 跨会话积累 |
| 4 程序性记忆 | 学到的技能和操作流程 | 持久化 | 复用做事方法 |
| 5 核心记忆 | 用户画像、系统人设 | 持久化、手动改 | 定义"它是谁" |
判断一个框架成不成熟,就看它怎么处理这五层:是全塞进一个配置文件里,还是每层有独立的存储和检索策略。后者才谈得上"成长"。
五、实战:一套多 Agent 协作怎么转起来
说个真实的组合(个人工作室场景,跑了几个月):
- 编排中枢用本地优先 Agent:管多模型路由、定时任务、跨工具编排。它的 fallback 链保证单家模型故障不中断整个工作流。
- 代码任务外包给 Git 深度集成的编码 Agent,各跑各的环境,互不干扰。
- 知识沉淀交给专门的角色:把散落的过程记录提炼成能复用的结论和证据路径,写进本地知识库,再按发布边界对外输出。
- 记忆分五层落:人设写进配置,技能写进技能库,事实写进长期知识库,对话摘要留在短期层。
这套组合最值钱的经验就一条:别指望一个 Agent 干所有事,让每个 Agent 干它最擅长的那一层,中间用明确的分工边界串起来。
六、新手最容易踩的五个坑
- 一上来就上多 Agent。协调成本远超预期。先单 Agent 跑通,再谈拆分。
- 迷信全自动。人在环路上更可控。删除、发布、付款这类动作留人工确认。
- 选完框架才想起记忆。框架选好了发现它记不住东西。选型时就把记忆架构放进评估。
- 把低代码当万能。原型阶段好用,需求一复杂就卡脖子。预留"低代码起步、代码级承接"的迁移路。
- 云平台数据依赖。数据上了云平台,搬走的成本很高。重要数据优先本地优先方案。
七、按场景抄作业
| 你的场景 | 推荐组合 |
|---|---|
| 个人自动化 + 隐私敏感 | 本地优先 Agent(多模型 fallback) |
| 快速验证一个想法 | 低代码平台原型 → 代码级框架承接 |
| 团队协作 + 要审计 | 云端编排平台 |
| 长期对话 + 知识管理 | 带 5 层记忆架构的框架 |
| 复杂多步工作流 | 状态图编排框架 |
来源与延伸
证据来源:深度研究页《AI Agent 生态研究》(2026-06 调研,18+ 框架逐一对比);MemGPT/Letta 五层记忆设计(MemGPT 论文)。
延伸阅读(同系列):
- 《多 Agent 协作方法论》—— 10 个协作框架与 10 个反模式
- 《Agent 必读论文》—— 10 篇经典论文与架构启示
- 《Agent 框架学习地图》—— 12 个开源仓库的逐仓学习路径
本文为「安大王的 AI 邪修攻略」系列文章,基于真实调研与运行经验整理。