别急着续配音会员:25MB 的 KittenTTS 塞进笔记本就能开口;盲测里,Chatterbox Turbo 对 ElevenLabs 同代款的胜率是 65.3%;Fish S2 Pro 的中英念错率(WER)0.54%/0.99% 压过一批闭源付费系统——而这一整套,月费 0。
TL;DR
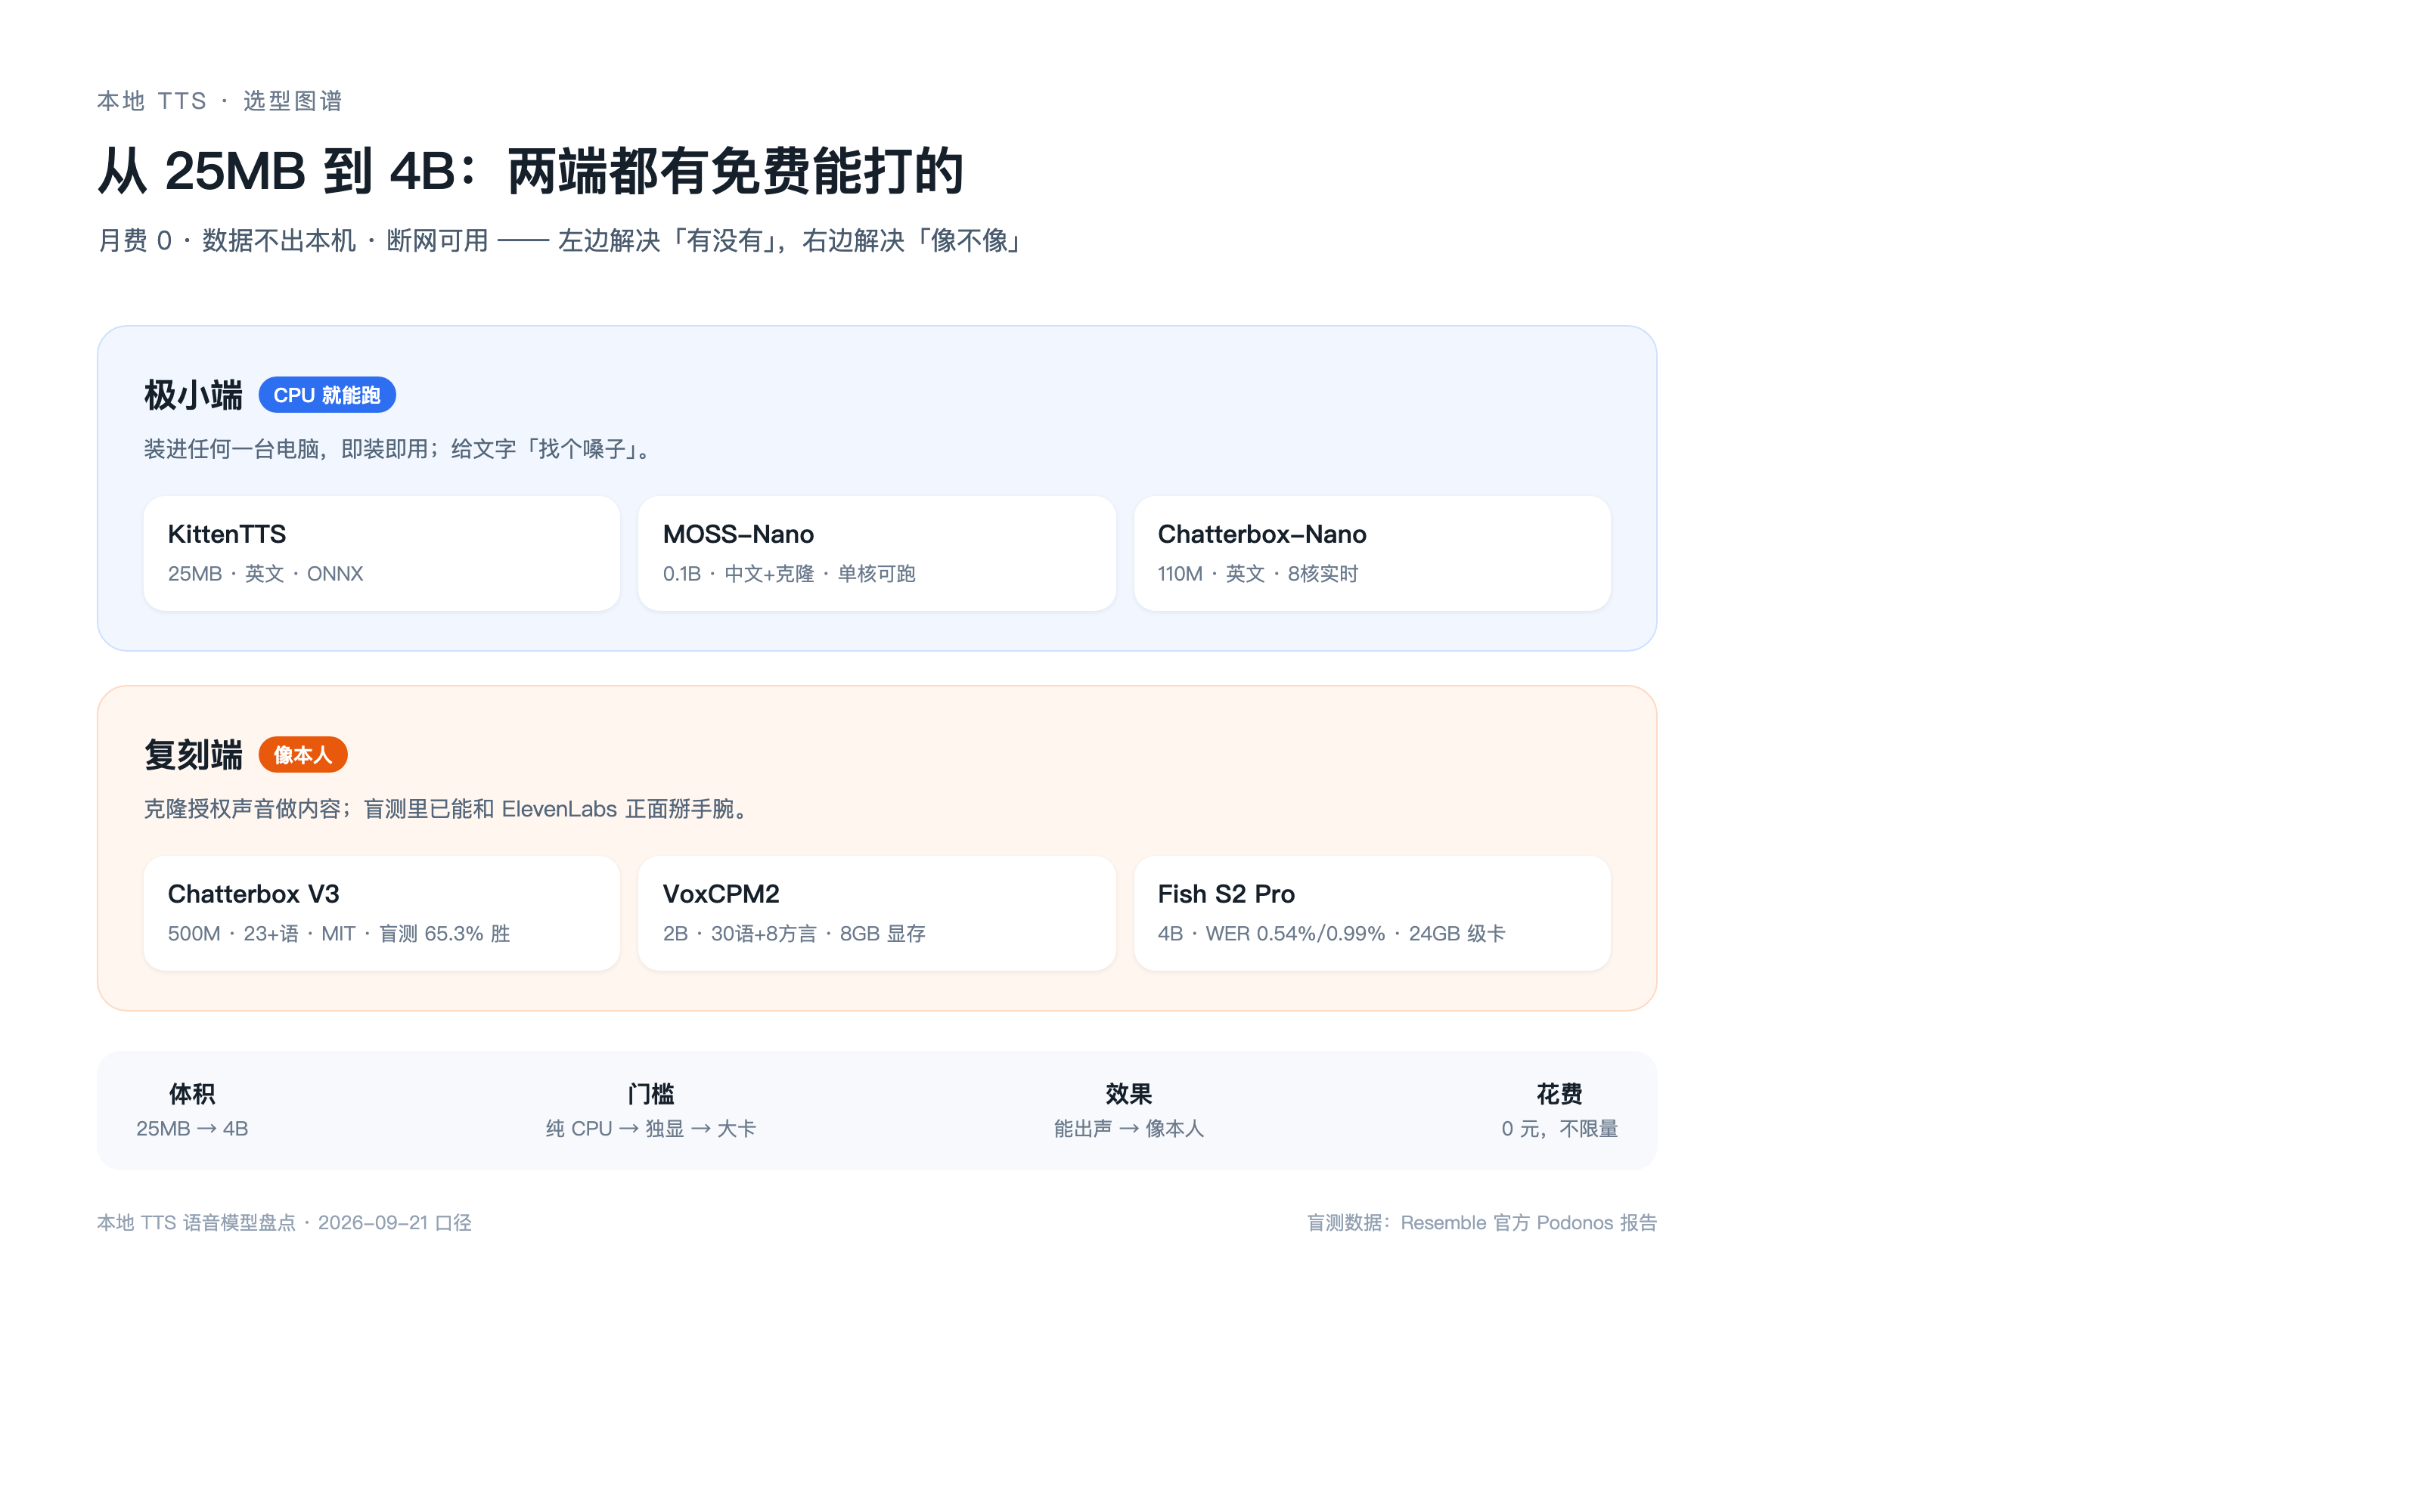
- 极小端(CPU 就能跑,全免费):KittenTTS 25MB(英文)、MOSS-TTS-Nano 0.1B(中文+克隆)、Chatterbox-Nano 110M(英文)。
- 复刻端(「像本人」):Fish S2 Pro 4B(评测最猛、许可最严)、VoxCPM2 2B(Apache-2.0、30 语+8 方言、苹果芯片能跑)、Chatterbox V3 500M(MIT、23+ 语言)。
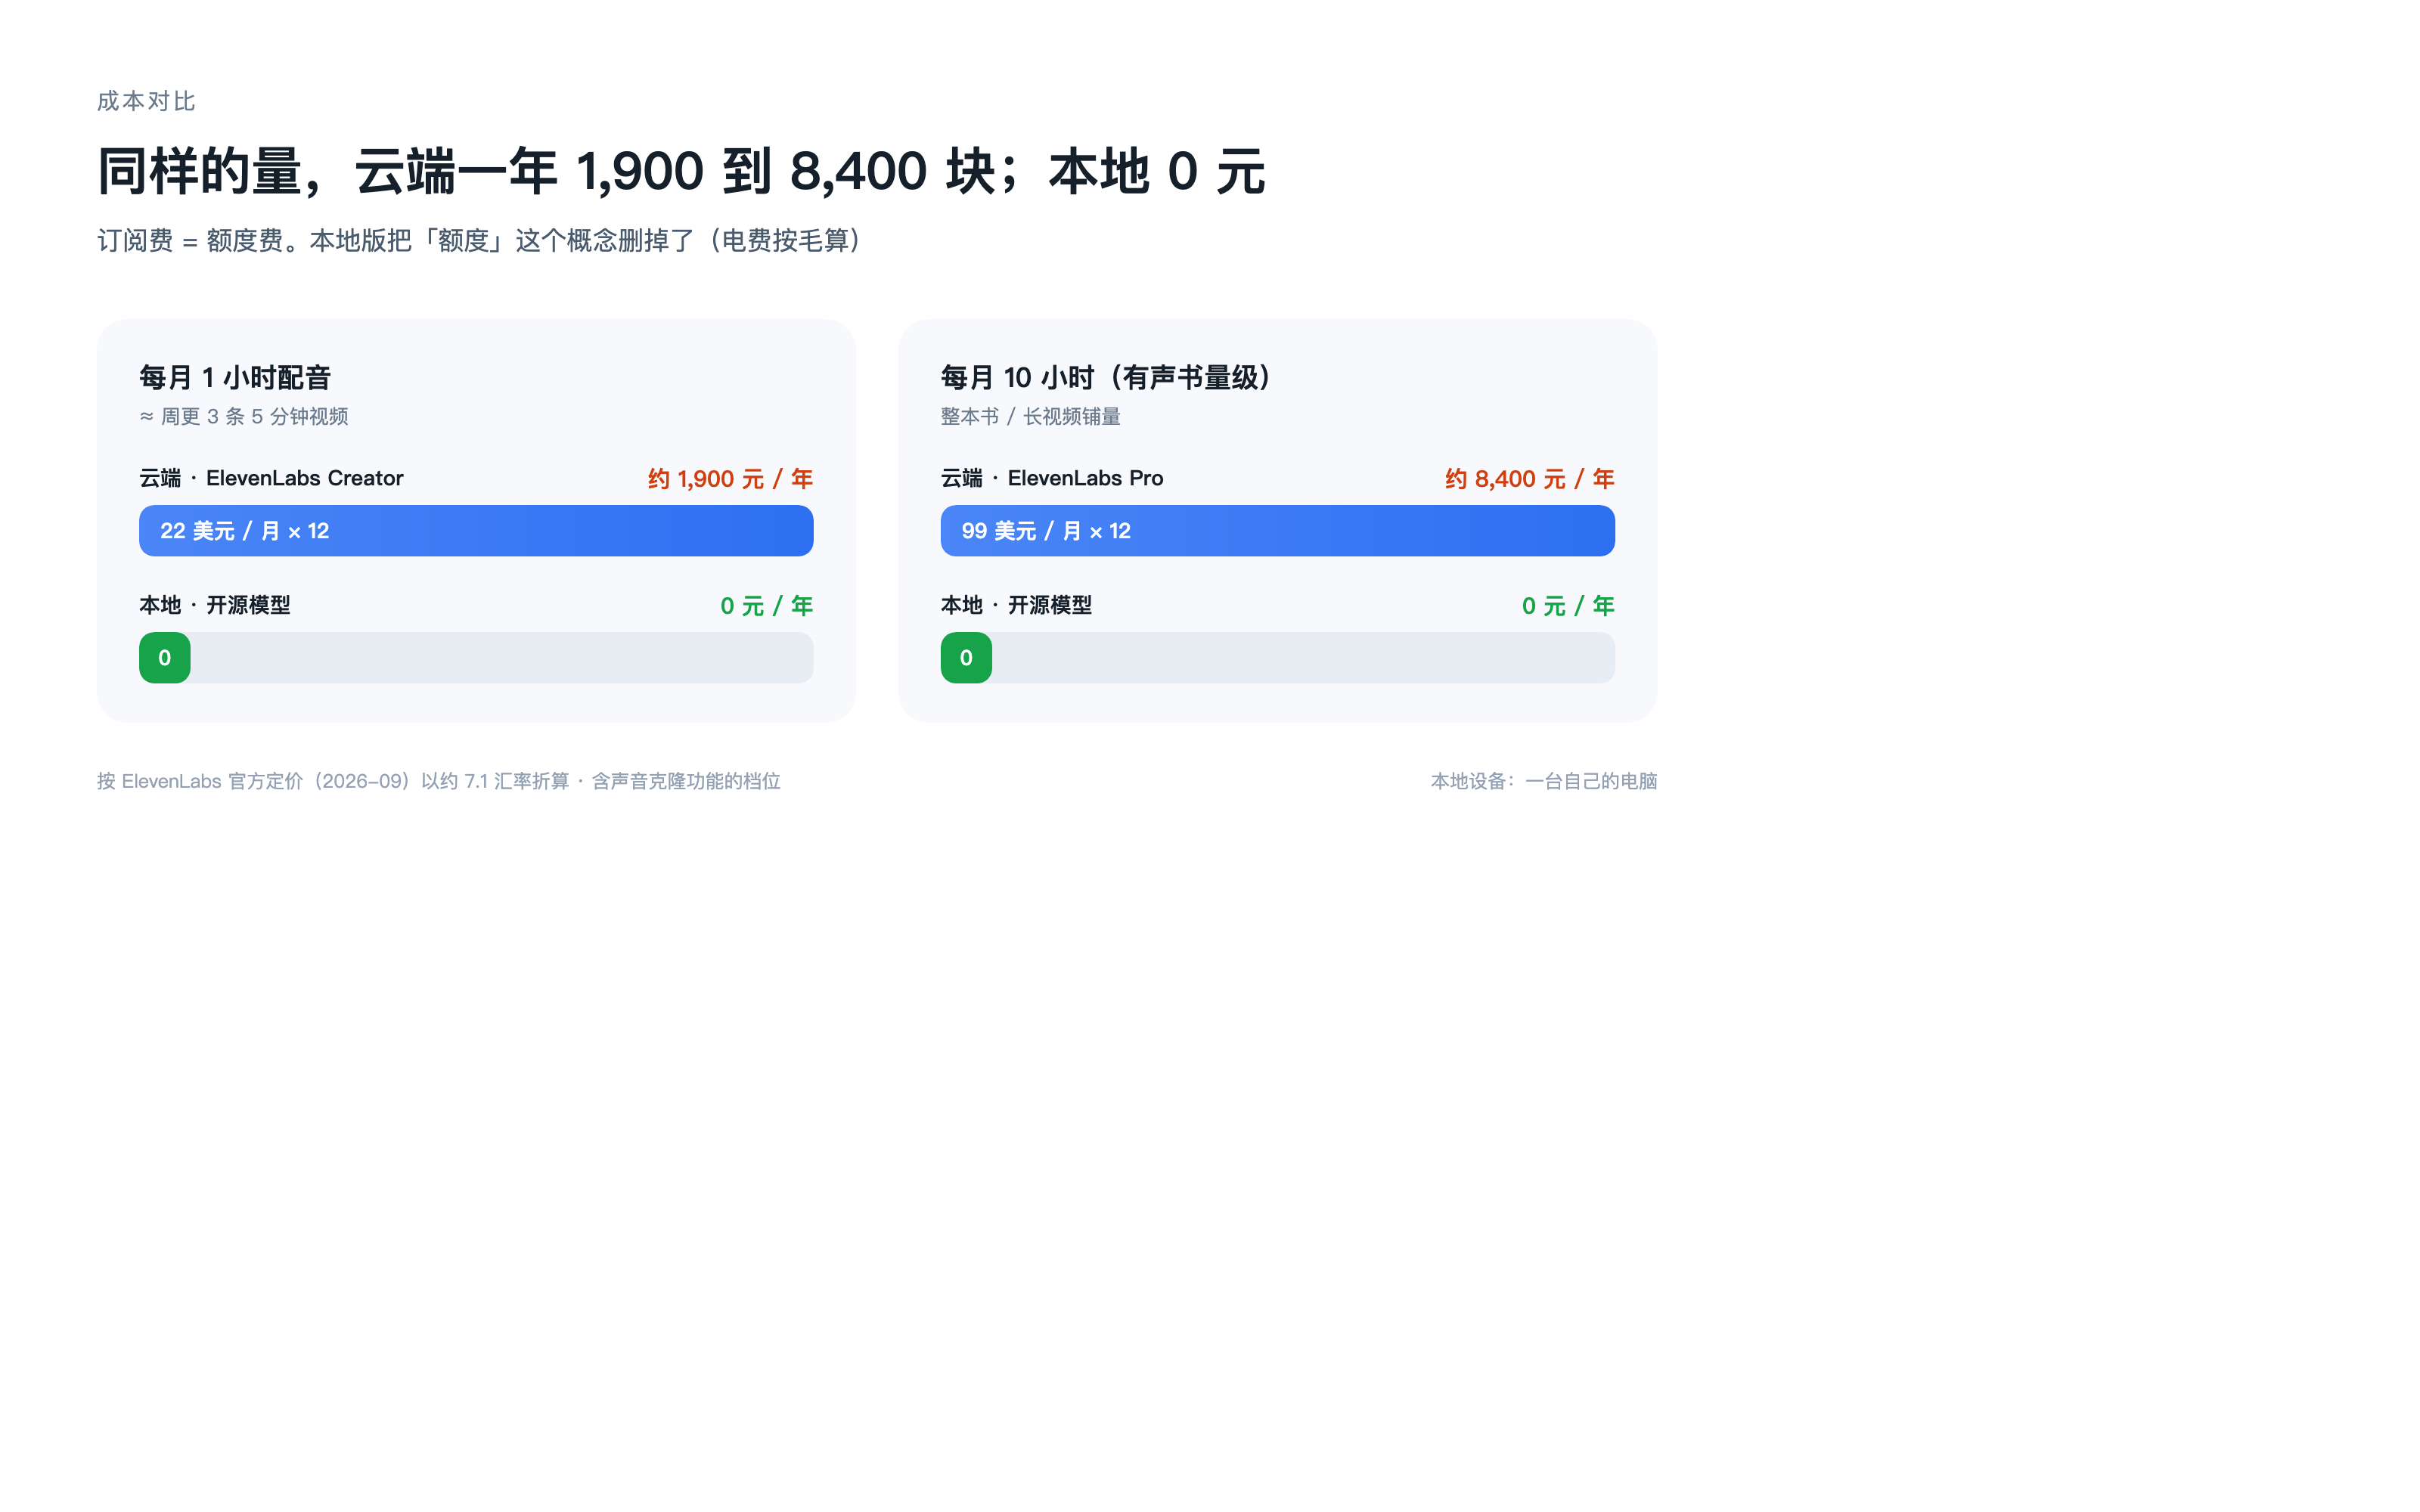
- 值多少:盲测里开源款对 ElevenLabs 胜率 65.3%;同量级云端配音一年要 1,900 到 8,400 块,本地 0 元、不限量。
- 一句话选型:只想让文字出声 → 极小端;要克隆自己或授权声音做内容 → 复刻端;想商用,先翻 LICENSE 再动手。
- 一个警示:微软 VibeVoice 的 TTS 代码曾因滥用案例被整段下架——克隆这事,合规比效果更要紧。
- 链接、下载渠道、安装命令、两段可复制的提示词,都在文末。
效果先行:先看「两端」的数字
| 极小端 | 复刻端 | |
|---|---|---|
| 代表体积 | 25MB(KittenTTS nano,15M 参数) | 500M(Chatterbox V3)到 4B(Fish S2 Pro) |
| 硬件 | 普通 CPU,无需显卡 | 中端以上 GPU;VoxCPM2 在苹果芯片走 MPS 也能跑 |
| 语言 | 英文(Kitten);中英等 20 语(MOSS) | 23 到 80+ 语言,含中文方言 |
| 克隆 | MOSS-Nano 支持(长文自动分块) | 这就是它们的看家本领 |
| 花钱 | 0 | 0(用自己机器) |
一句话版:小模型解决「有没有」,大模型解决「像不像」。
效果对标:离「官方顶配」多近?
直接盲测,开源款已经赢过 ElevenLabs 一局。 Resemble 官方做了一组盲测(Podonos 平台:5 到 10 秒参考音、同一段文本、零样本):Chatterbox Turbo 对阵 ElevenLabs Turbo v2.5,65.3% 的听众选 Chatterbox,24.5% 选 ElevenLabs(其余平票);对阵 Cartesia Sonic 3 是 49.8%,对阵 VibeVoice 7B 是 59.1%。
念错率(WER,越低越好):Fish S2 Pro 中文 0.54%、英文 0.99%,在其官方评测里好于 Qwen3-TTS(0.77 / 1.24)、MiniMax Speech-02(0.99 / 1.90)、Seed-TTS(1.12 / 2.25)——全是闭源或云端系统。
克隆「像不像」(SS 相似度,越高越好):同一张评测表(CV3-Eval)里,0.8B 的 IndexTTS2.5-RL 平均 73.6、2B 的 VoxCPM2 72.0、CosyVoice3 中文单科 80.0——彼此只差几分,到了人耳要盲测才分得出的区间。
行业背景补一句:独立盲测榜 Speech Arena 的榜首两个月换过两次(Inworld 顶掉 ElevenLabs,随后阿里的 Qwen-Audio 登顶),前几名彼此只差几十 Elo。「最好听」不再由付费巨头垄断,比的就是谁更合适你的场景。
人话版:日常口播、配音、有声书,本地这几款跟订阅制产品的听感在同一档;极端情绪、超长文本的稳定性各家有强弱,最稳的办法是拿你自己的稿子去在线 Demo 试听一遍——耳朵说了算。
成本:一年能省多少钱
ElevenLabs 官方口径:1,000 字符约等于 1 分钟音频,免费档每月只送 10,000 credits(约 10 分钟),多一点就要按月付费:
| 你的用量 | 云端(ElevenLabs 官方价格) | 本地版 |
|---|---|---|
| 每月 10 分钟 | 免费档,刚好用完 | 不限量 |
| 每月 1 小时(周更 3 条 5 分钟配音) | Creator 档 22 美元/月(约 160 块)→ 一年约 1,900 块 | 0 元 |
| 每月 10 小时(有声书量级) | Pro 档 99 美元/月(约 700 块)→ 一年约 8,400 块 | 0 元 |
| 要「像本人」的克隆 | Creator 档起才给专业克隆(22 美元/月起) | Apache/MIT 模型免费、不限次 |
国内对标:魔音工坊会员 48 元/月起,「一句话克隆」加不限下载的全场声音会员 199 元/月起(第三方攻略页整理,以官网为准)。
一句话总结:订阅费的本质是「额度费」。本地版把额度这个概念删掉了——跑一小时语音,电费按毛算。
诚实提示:想跑到「榜霸」那档(Fish)需要一块大显存显卡;装环境要花一杯咖啡的工夫。省的是长期的钱和额度,花的是首次折腾的时间。
运行环境:哪台设备能跑
| 你的设备 | 能跑什么 | 实感 |
|---|---|---|
| 任何一台电脑(纯 CPU) | KittenTTS、MOSS-TTS-Nano | 小模型即装即用;MOSS 单核都能出声 |
| 安卓手机 / 浏览器 | MOSS-TTS-Nano | 官方有安卓 ONNX 示例、浏览器朗读插件 |
| Mac(M 系芯片) | VoxCPM2(自动 MPS)、MOSS(mlx) | VoxCPM2 还有 GGUF 版走 Metal,速度比实时略慢 |
| 8GB 显存独显 | VoxCPM2(约占 8GB)、Chatterbox 全系、IndexTTS / CosyVoice | 4090 上约 3 秒出 10 秒语音(RTF 0.3) |
| 24GB 级大卡 | Fish S2 Pro 4B | 官方流式演示用单张 H200——天花板住在这儿 |
口径来自各家官方 README 与文档:Windows / macOS / Linux 全支持,Python 3.8 起步(Chatterbox 要求 3.11)。
核心优势:凭什么选它
- 月费归零,还不限量——云端按月卖额度,本地一次装好,之后随便跑。
- 声音不出本机——参考音频和生成内容全程离线,不传任何服务器。
- 断网照常干活——飞机上、没网时一样合成。
- 克隆自由——不再按次、按档收费,克隆自己或授权声音随取随用。
- 许可上有的选——Apache/MIT 那几款(VoxCPM2、Chatterbox、MOSS、Kitten)可商用;Fish 是研究许可,商业项目绕开即可。
- 梯度全覆盖——25MB 到 4B,从老笔记本到工作站的设备都有位置。
极小端:装进兜里的三个
1. KittenTTS——25MB,小到离谱
- 15M 到 80M 参数、25 到 80MB 体积、ONNX 推理,CPU 实时;8 个音色、可调语速、24kHz 输出。
- 许可 Apache-2.0(可商用),GitHub 1.5 万星,带免费在线试听。
- 短板很明确:只支持英文。中文需求看下一个。
- 一句话装好(Python 3.8+ 环境):
pip install https://github.com/KittenML/KittenTTS/releases/download/0.8.1/kittentts-0.8.1-py3-none-any.whl
2. MOSS-TTS-Nano——0.1B,中文和克隆都能打
- 国产团队(OpenMOSS × MOSI.AI)出品:0.1B 参数、支持中英等 20 种语言、48kHz 双声道输出。
- 卖点是不挑机器:流式生成 4 核 CPU 够用;ONNX 版官方实测在 MacBook Air M4 上单核能跑,还支持 mlx(苹果芯片加速)。
- 克隆走「给参考音频即用」,长文本自动分块,不掉音色;命令行
moss-tts-nano serve起服务,还有现成的浏览器朗读插件。 - 许可 Apache-2.0,GitHub 4.4 千星(2026 年 4 月发布的新项目)。
3. Chatterbox-Nano——110M,英文实时款
- Resemble AI 出品,MIT 许可;8 核 CPU 上 3 倍实时。
- 支持「副语言标签」:文本里直接写
[laugh]、[chuckle]这类标记,说话带笑声和叹气,真实感加一档。 - 只支持英文。同门的 Multilingual V3 见下文复刻端。
补充一个:Supertonic(99M、31 语、速度极快)曾是这个赛道的明星,但仓库已归档停更、且不支持中文——新项目别拿它当主力。
复刻端:三款「像本人」的
1. Fish Audio S2 Pro——数据最猛,许可最严
- 4B 参数、训练音频 1000 万+ 小时、80+ 语言。
- 官方评测里中英文 WER 双双登顶(中文 0.54%、英文 0.99%,好于 Seed-TTS、MiniMax 等一批闭源系统);「音频图灵测试」得分同样排在开源最前。
- 最好玩的是词级情绪控制:文本里插
[whisper]、[excited]这类标签,15000+ 种写法自由组合。 - 但注意:许可是自定义的「研究许可」,条款很硬,商用会追责——自己玩可以,商用先绕道。
2. VoxCPM2——商用最放心,还能「画」新声音
- 清华系 OpenBMB 出品:2B 参数、30 种语言+8 种中文方言(粤语、四川话、闽南话都在)。
- 两个独门功能:Voice Design——不给参考音频,用一句文字描述直接创造全新声音;终极克隆——参考音频加原文一起给,连语气节奏都复刻。
- 输出 48kHz,苹果芯片自动走 MPS(不用折腾);许可 Apache-2.0,可商用。GitHub 3.8 万星。
3. Chatterbox Multilingual V3——许可最宽松的全能选手
- 500M 参数、23+ 语言、MIT 许可;跨语言克隆稳(中文嗓子说英文不掉音色)。
- 同厂还有 Turbo(350M、低延迟)和单独的中文精调包,是「不想踩许可坑」的默认答案。
再加两个国产选项:CosyVoice 3(阿里系,Apache-2.0,2.4 万星)和 IndexTTS(B 站系,中文情绪控制很强,最新已到 2.5,商用需联系官方)——选择困难时,先拿在线 Demo 听一耳朵最实在。
三步上手
- 先试听:上表几家都有在线 Demo,打开就能听,不用装任何东西。
- 装最小的:KittenTTS 一条 pip(见上文);中文换 MOSS-TTS-Nano,
git clone后python infer.py,参考音频 10 秒即克隆。 - 上强度:
pip install voxcpm(苹果芯片自动 MPS)或pip install chatterbox-tts;还嫌不够像,再考虑 4B 的 Fish。
选型速查表
| 模型 | 体积/参数 | 语言 | 克隆 | 许可 | 适合谁 |
|---|---|---|---|---|---|
| KittenTTS | 25 到 80MB | 英文 | 无 | Apache-2.0 | 桌面小工具、英文朗读 |
| MOSS-TTS-Nano | 0.1B | 中英等 20 语 | 支持 | Apache-2.0 | 中文入门、轻量克隆 |
| Chatterbox-Nano | 110M | 英文 | 支持 | MIT | 英文实时、端侧 |
| Fish S2 Pro | 4B | 80+ | 支持(强) | 研究许可(严) | 效果优先、非商用 |
| VoxCPM2 | 2B | 30 语+8 方言 | 支持(强) | Apache-2.0 | 中文商用、苹果芯片 |
| Chatterbox V3 | 500M | 23+ | 支持 | MIT | 跨语言、怕许可坑 |
| CosyVoice 3 | 0.5B | 中英日韩等 | 支持 | Apache-2.0 | 国产备选 |
三个坑(都有人栽过)
- 许可分三级:MIT/Apache(放心商用)→ 研究许可(Fish 这类,条款写明商用追责)→ 非商用。做产品前先翻 LICENSE 的商用条款,别等收律师函。
- 语言别默认:KittenTTS 只英文、Supertonic 31 语偏偏没中文——下载前翻到「Supported Languages」再动手,省得白下几个 G。
- 克隆有红线:微软 VibeVoice 在 2025 年 9 月因滥用案例把 TTS 代码整段下架(README 至今挂着这则说明)——未经授权克隆真人声音、做假语音,会被平台级反制;发布 AI 生成语音记得按规定标注。
链接与下载渠道
下载提速先说:HuggingFace 下载慢,先在终端加一行 export HF_ENDPOINT=https://hf-mirror.com 走公开镜像;有 ModelScope(魔搭)版的优先用国内源。
逐款直达:仓库 → 模型下载 → 试听
- KittenTTS:仓库 https://github.com/KittenML/KittenTTS | 下载(25MB 版)https://huggingface.co/KittenML/kitten-tts-nano-0.8-int8 | 试听 https://huggingface.co/spaces/KittenML/KittenTTS-Demo
- MOSS-TTS-Nano:仓库 https://github.com/OpenMOSS/MOSS-TTS-Nano | 下载 https://huggingface.co/OpenMOSS-Team/MOSS-TTS-Nano(国内源:https://modelscope.cn/models/openmoss/MOSS-TTS-Nano)| 试听 https://openmoss.github.io/MOSS-TTS-Nano-Demo/
- Chatterbox(含 Nano / V3 / 中文精调包):仓库 https://github.com/resemble-ai/chatterbox | 下载 https://huggingface.co/ResembleAI/chatterbox-nano、中文包 https://huggingface.co/ResembleAI/Chatterbox-Multilingual-zh-cmn | 试听 https://huggingface.co/spaces/ResembleAI/Chatterbox-Multilingual-TTS
- VoxCPM2:仓库 https://github.com/OpenBMB/VoxCPM | 下载 https://huggingface.co/openbmb/VoxCPM2(国内源:https://modelscope.cn/models/OpenBMB/VoxCPM2)| 试听 https://huggingface.co/spaces/OpenBMB/VoxCPM-Demo
- Fish S2 Pro:仓库 https://github.com/fishaudio/fish-speech | 下载 https://huggingface.co/fishaudio/s2-pro | 安装文档 https://speech.fish.audio/install/
- CosyVoice 3:仓库 https://github.com/FunAudioLLM/CosyVoice | 下载(国内源)https://www.modelscope.cn/models/FunAudioLLM/Fun-CosyVoice3-0.5B-2512 | Demo https://funaudiollm.github.io/cosyvoice3/
- IndexTTS(已更新到 2.5):仓库 https://github.com/index-tts/index-tts | 下载(国内源)https://modelscope.cn/models/IndexTeam/IndexTTS-2.5 | 试听 https://huggingface.co/spaces/IndexTeam/IndexTTS-2.5-Demo
技能包(给你的 AI 助手一行装)
- MOSS 语音技能:https://clawhub.ai/luogao2333/moss-tts-voice(文本转语音+实时克隆,多格式输出)
- 本地批量朗读:
npx skills add openclaw/openclaw@sherpa-onnx-tts - 连网免费声(不想装模型):
npx skills add aahl/skills@edge-tts
AI 配置提示词(复制即用)
帮我在这台电脑上搭一套本地 TTS(HuggingFace 下载慢就设 HF_ENDPOINT=https://hf-mirror.com,有 ModelScope 版的优先用魔搭源),按顺序来:
1. 先装最小的 KittenTTS(按官方 README 的 pip 命令),跑一版英文样例;
2. 再装 MOSS-TTS-Nano(中文+克隆),用我给的 10 秒参考音频克隆,生成一段中文;
3. 对比两者的音质、生成速度、内存占用,做成一张表给我;
4. 我的机器配置是:____;如果够装 VoxCPM2(终极克隆),先估算资源占用再问我要不要装;
5. 每一步都帮我核对许可条款,标出「能不能商用」。
用法样例(对模型提要求时这么写)
- 造新声音(VoxCPM2 Voice Design):「四十岁上下的女声,语速偏慢,尾音放松,带一点南方口音的松弛感」
- 情绪插标(Fish S2 Pro):台词直接写成「[叹气] 今天真的累了 [轻笑] 不过都过去了」这种格式,密度自己控制
来源与时效
- 数据抓取于 2026-09-21:GitHub 星数(VibeVoice 54440|VoxCPM 37837|Fish Speech 32765|Chatterbox 26501|IndexTTS 24112|CosyVoice 23711|KittenTTS 15478|MOSS-TTS-Nano 4385)与各仓库 README。
- 对比数据:Chatterbox 盲测来自 Resemble 官方页(resemble.ai/learn/models/chatterbox-turbo,Podonos 平台);相似度/WER 同表数据来自 IndexTTS 仓库评测表(CV3-Eval);Fish 成绩来自其官方评测(技术报告 arXiv 2603.08823);Speech Arena 读数为第三方报道(oakgen.ai、theplanettools.ai,2026-05 与 07)。
- 价格:ElevenLabs 官方定价(经 creditforstartups.com 整理,2026-09 抓取,美元价按约 7.1 汇率折人民币);魔音工坊为第三方攻略页整理,以官网为准。
- 下载渠道以各仓库 README 标注的官方源为准(HuggingFace / ModelScope / GitHub Releases);硬件口径:VoxCPM2 显存表来自官方 README,Fish 部署口径(24GB 级显存)来自第三方 GPU 指南引用官方文档。
- 语音模型迭代快,动手前以最新 README 和 LICENSE 为准。